競艇AIの回収率は、測り方を変えるだけで動く。会場別では最大21.6ポイントのブレを実測した
「競艇 AI予想 回収率」で検索すると、「回収率100%超」を掲げる記事や動画が出てくる。このツールの結論を先に言うと、そういう数字は出ない。 検証期間で測った実測では、3連単の回収率は78%前後、単勝でも90%前後で頭打ちになる。100%を超えたことは、まとまった検証では一度もない。
では「回収率100%超」を名乗る記事は、何を測っているのか。今回は自分自身の数字を材料に、その仕組みを確かめた。同じツール・同じ買い方でも、検証期間の切り方や対象レースの絞り方を変えるだけで、回収率は数字が動く。会場別に見ると、その動き幅はもっと大きい。 「100%超」という一点の数字は、その振れ幅のどこかを切り取れば作れてしまう。
結論: 母集団を変えるだけで数字は動く。会場だと動き幅は一桁違う
対象は検証(モデルの検証期間だけで実測すること)。締切は2026年9月23日(執筆日の前日、これより後のレースは結果が出そろっていない)。買い方はこの連載でずっと使っている単勝 本命1点(モデルが最も有力とみた1艇の単勝を100円買う)と3連単 上位6点(モデルの参考順位の上位6組を各100円買う)。
同じモデル・同じ買い方のまま、検証に回す期間の割合(valid_frac)だけを15%〜25%の間で5通り動かして測り直した。
| 何を変えたか | 単勝 本命1点の回収率 | 3連単 上位6点の回収率 |
|---|---|---|
| 検証期間の切り方(5通り) | 90.60%〜90.85%(差0.26pt) | 77.96%〜79.10%(差1.15pt) |
| 対象レースの絞り込み方(2通り) | 90.79%〜90.85%(差0.06pt) | ― |
| 会場別(24会場・同じ1つの検証期間) | 77.5%〜99.0%(差21.6pt) | 70.6%〜88.5%(差17.9pt) |
検証期間や母集団の定義を変えたときの動きは1ポイント前後。会場で切ると、その10〜20倍の幅で動く。 どちらも「同じツール・同じロジック」で測った数字であり、モデルの性能が変わったわけではない。数字が動くのは、測り方が変わったからである。
実験1: 検証期間の切り方を変えるだけで、数字は動く
検証は、日付順に並べたレースの末尾何%を「検証用」として取り分けるかで区間が決まる。この割合(valid_frac)を15%・18%・20%・22%・25%の5通りに変え、それぞれ学習からやり直して測った。
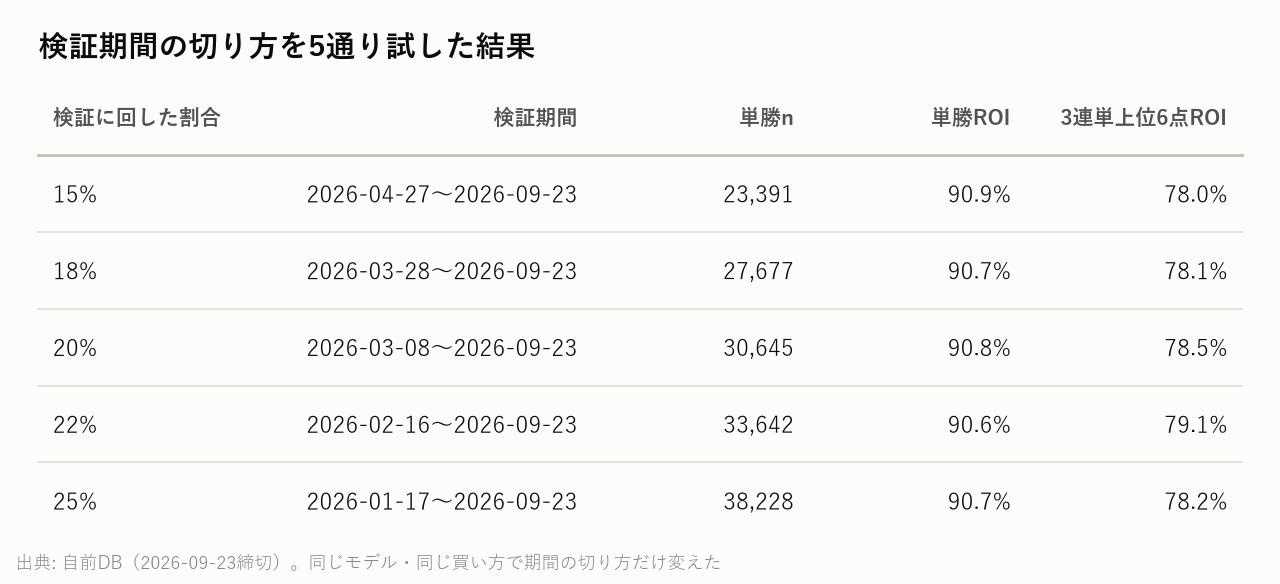
同じモデル構造・同じ特徴量・同じ買い方。検証に回す割合だけを変えた。締切は共通で2026-09-23、期間の始点だけが動く。
単勝は90.60%〜90.85%の間、3連単上位6点は77.96%〜79.10%の間に収まった。「%」の値としては1ポイント前後の違いだが、これだけで「90.6%」とだけ言うか「90.85%」とだけ言うかが変わる。 どちらも100%には届いていないので結論は変わらないが、もし損益分岐に近い水準で測っていたら、この程度の違いで「100%を超えた/超えなかった」が入れ替わってもおかしくない。
実験2: 対象レースの絞り込み方を変えても、動く(ただし幅は小さかった)
もう一つ、母集団の定義そのものを変える実験もした。標準の集計は「6艇とも完走したレースのみ」を対象にしている。これを「5艇以上(1艇が欠場しても、勝った艇が分かれば対象に含める)」に広げると、対象レース数が30,645→30,760に増える。
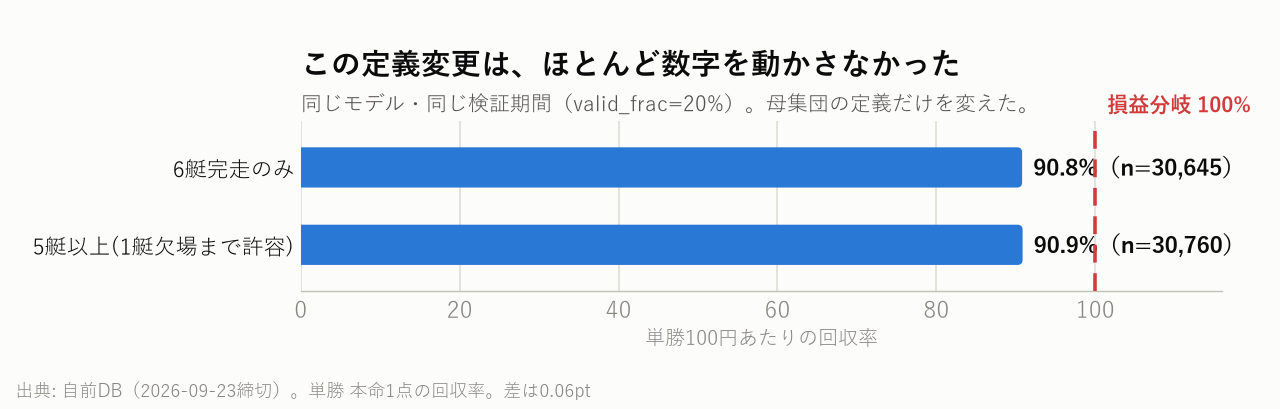
同じモデル・同じ検証期間(valid_frac=20%)。母集団の定義だけを変えた。
結果は90.79%→90.85%で、差はわずか0.06ポイント。 検証期間の切り方(差0.26〜1.15pt)に比べると、この定義変更はほとんど数字を動かさなかった。母集団の変え方によって、数字が動く幅は一様ではない。 どこを変えるかで、ブレの大きさそのものが変わる。
会場別に見ると、振れ幅はもっと大きい
ここまでは「検証期間」「絞り込み方」という、いわば測定の"ノイズ"だった。同じ1つの検証期間(2026-03-08〜2026-09-23、valid_frac=20%)を24会場に分けて集計すると、話はまったく違う大きさになる。
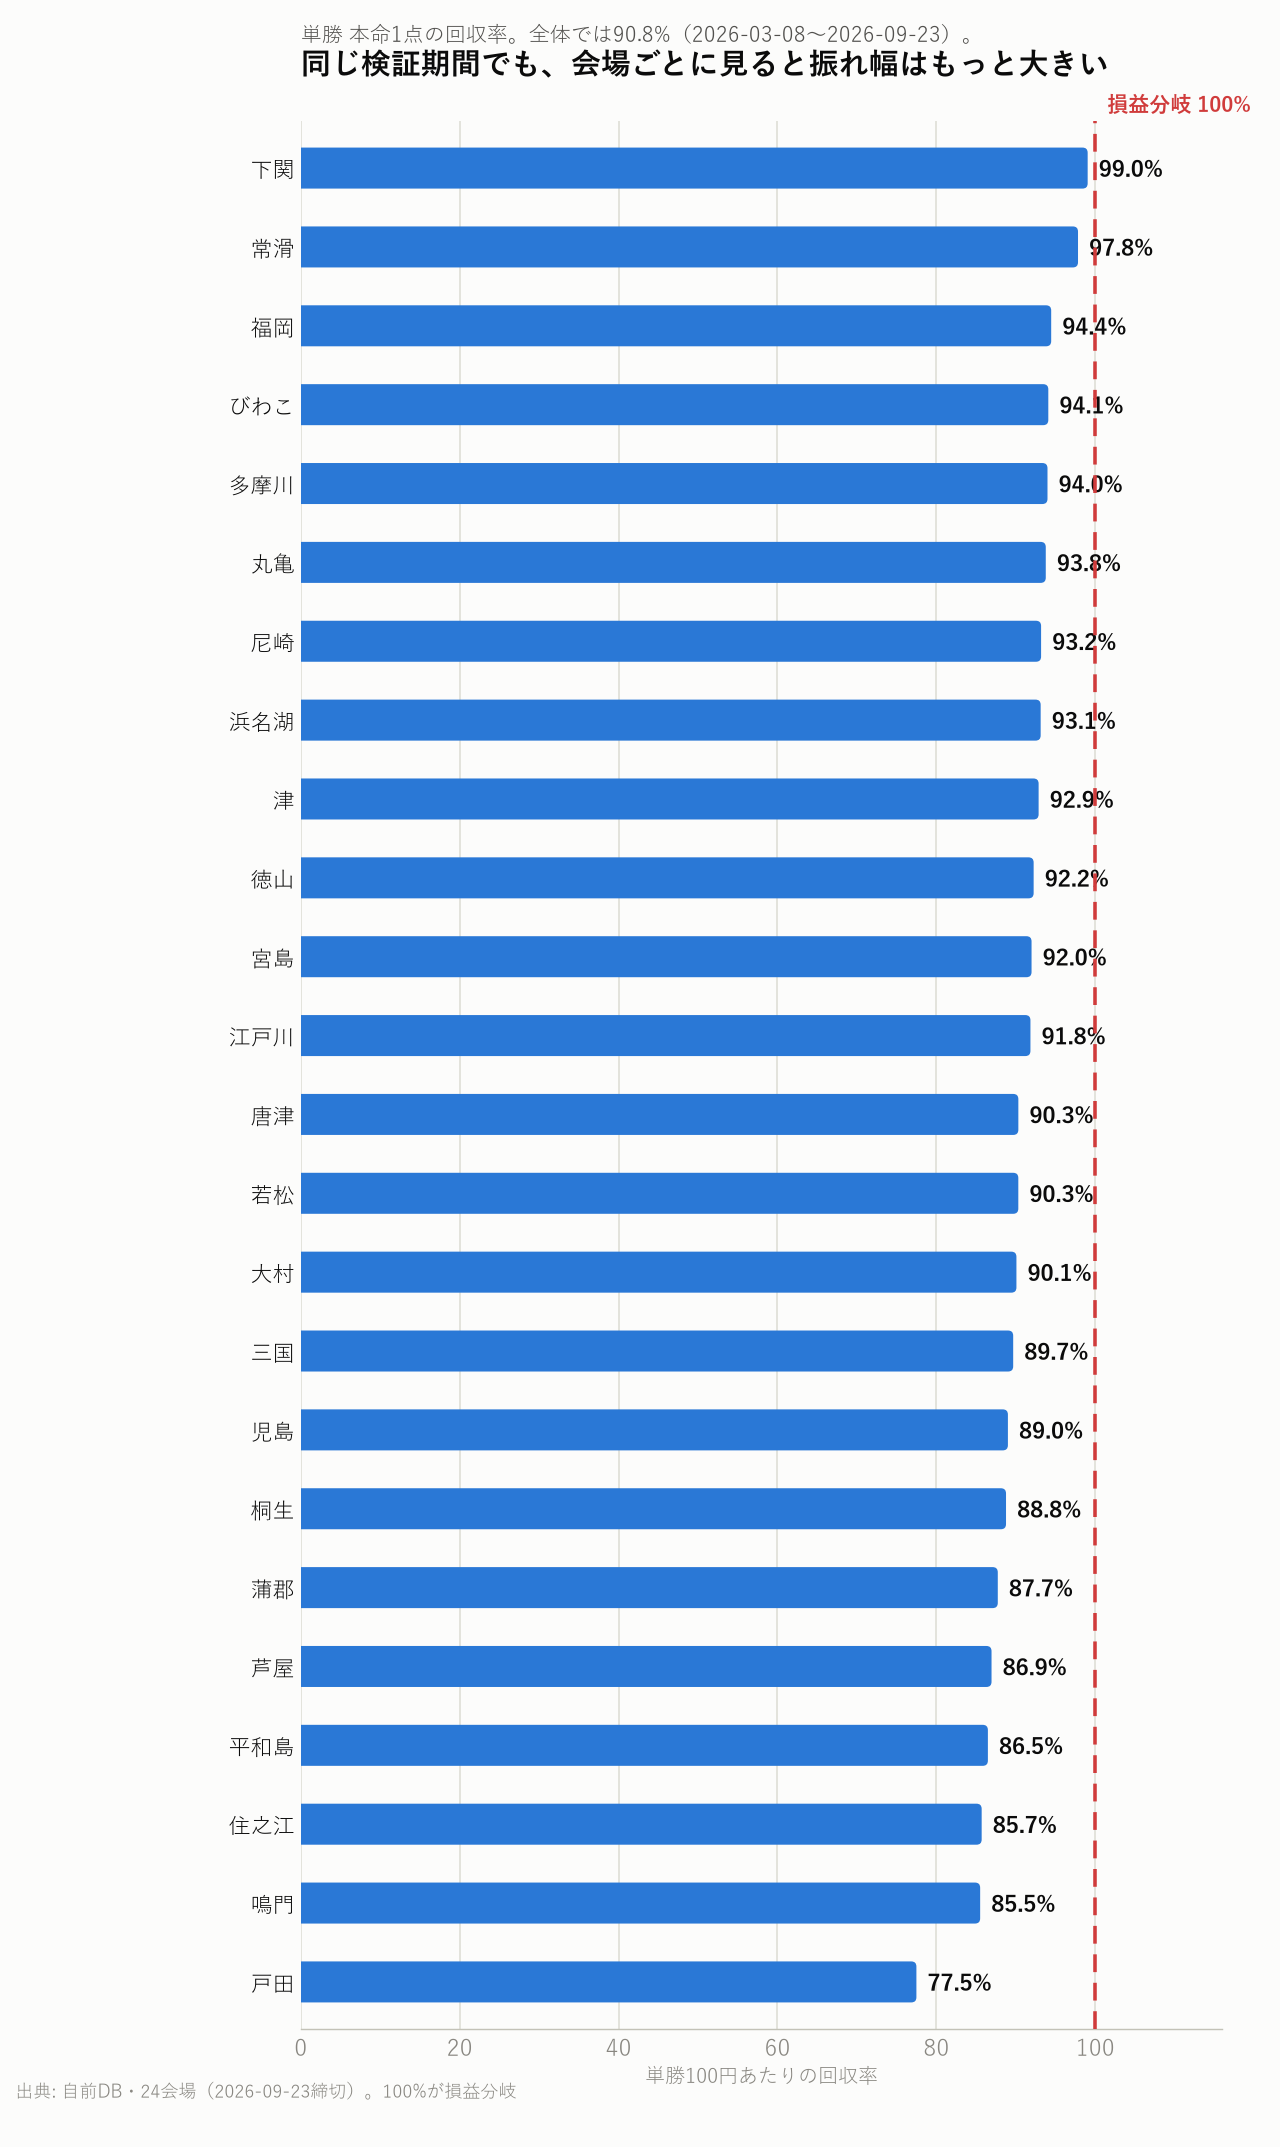
単勝 本命1点の回収率。全体では90.8%(2026-03-08〜2026-09-23)。100%が損益分岐。
一番良かったのは下関の99.0%、一番悪かったのは戸田の77.5%。差は21.6ポイント。3連単上位6点でも、下関の88.5%〜戸田の70.6%で17.9ポイントの差がついた。下関はこの検証で単勝・3連単の両方で最も良く、戸田は両方で最も悪い。 検証期間の切り方を変えたときの1ポイント前後の動きとは、桁が違う。
全24会場・両方の買い方をすべて出す。
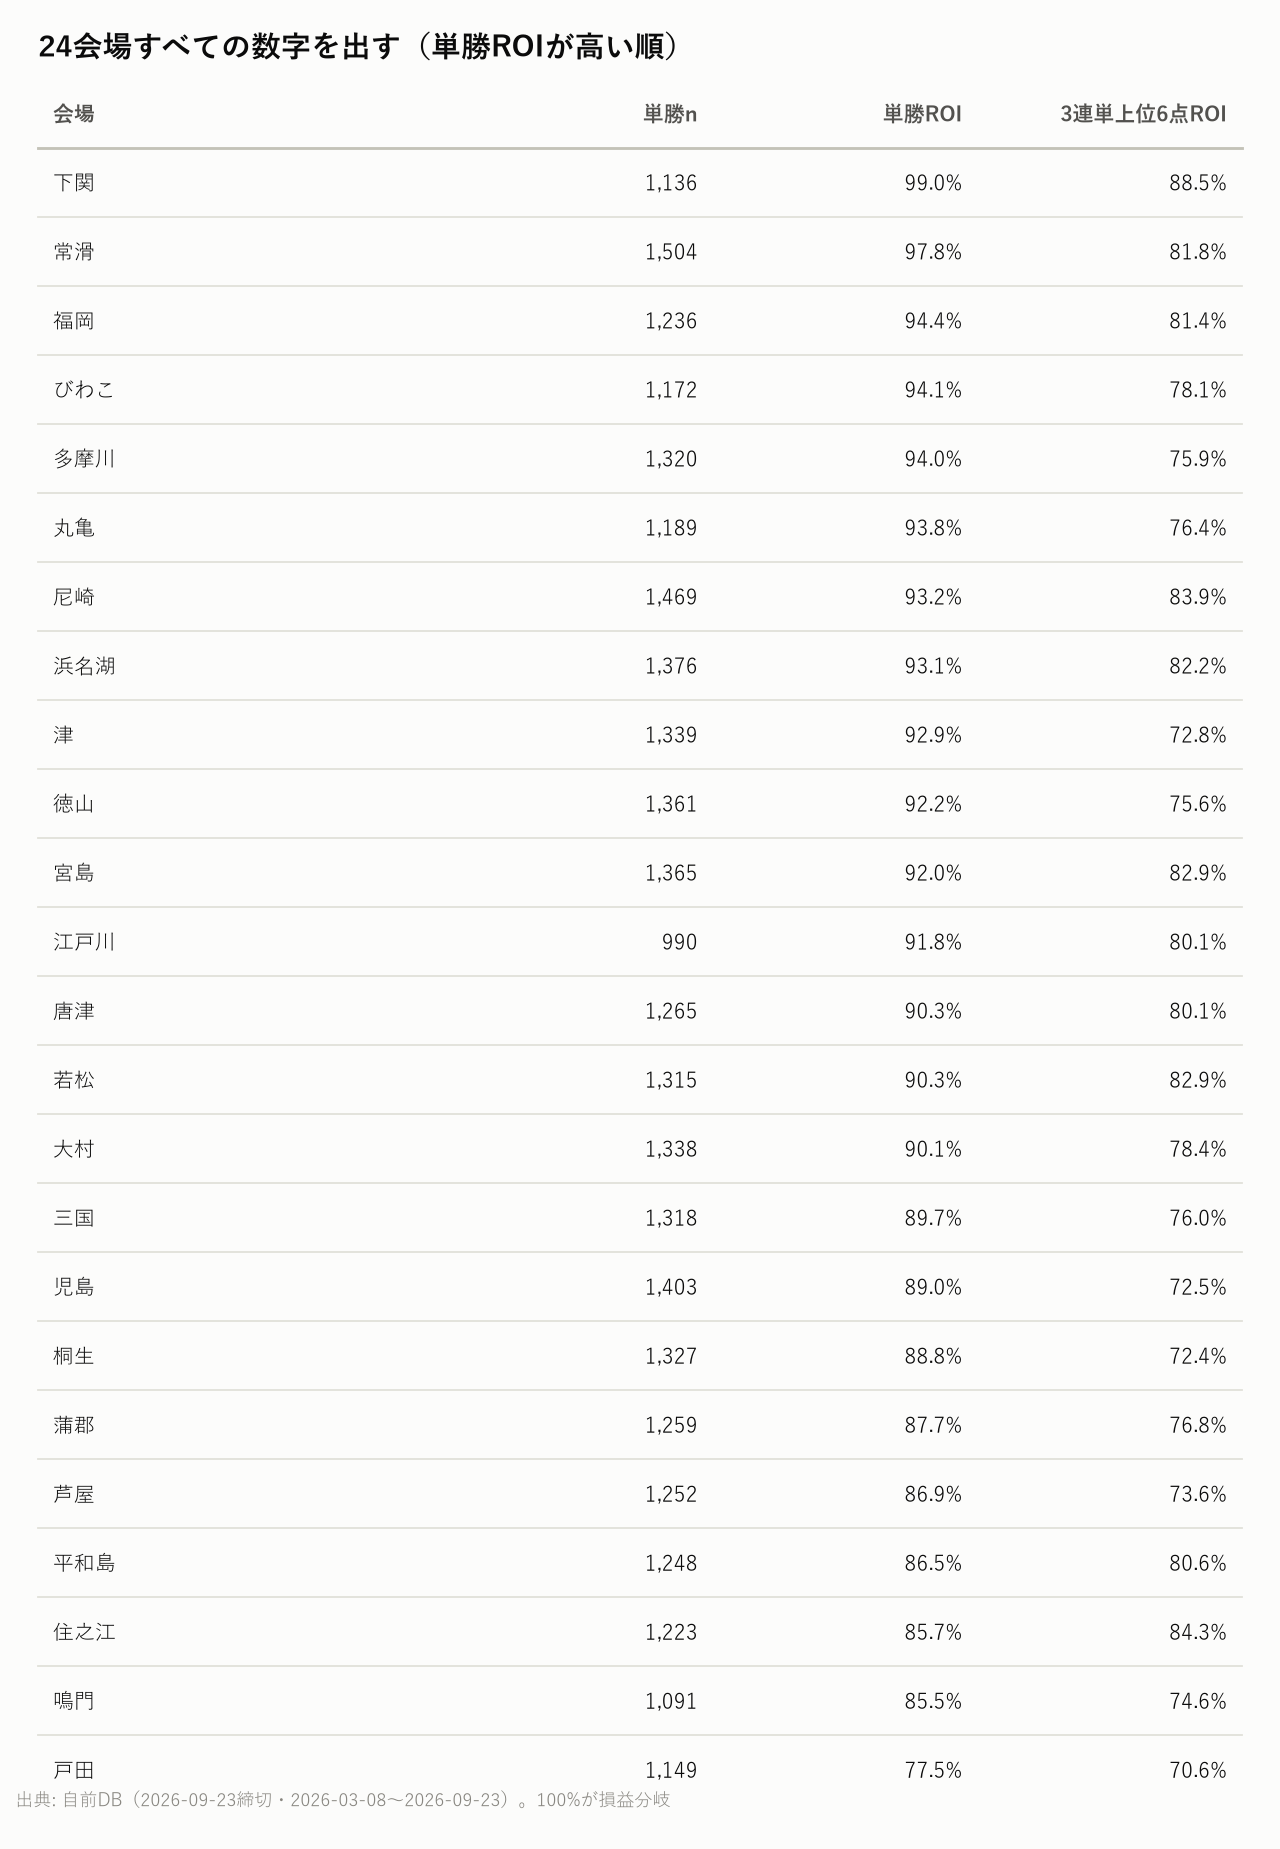
出典: 自前DB(2026-09-23締切・2026-03-08〜2026-09-23)。100%が損益分岐。
この検証では、24会場のどれも、単勝・3連単のどちらでも100%を超えなかった。 一番良く見える下関でさえ、単勝99.0%・3連単88.5%で届いていない。この点は以前の記事「会場ランキングの罠」で示した結論(検証期間の29,815レースのうち24会場のどれを選んでも100%に届かない)と同じ形が、今回・別の検証期間でも再現している。
なぜ「回収率100%超」を名乗る記事が出てくるのか
種明かしをすると、理由は多重比較(たくさんの候補の中から結果を見てから一番良いものを選ぶと、実際には差が無くても偶然差があるように見えてしまう問題)にある。
24会場は、実力に差が無かったとしても、レース数が有限である以上、回収率にはサイコロを振ったときのようなばらつきが乗る。24個の数字を並べれば必ずどれかが一番大きくなる。今回のように24会場・1つの検証期間を見ただけでも、単勝は下関99.0%〜戸田77.5%の21.6ポイント、3連単上位6点は下関88.5%〜戸田70.6%の17.9ポイントの幅ができた。
これが期間という軸まで増えると、候補の数はさらに掛け算で増える。以前の検証(会場ランキングの罠)では、24会場×3期間×2買い方=144通りを数えたところ、100%を超えたのはわずか3通り(2.1%)で、そのうち3つとも他の期間では100%を割っていた。候補を増やせば増やすほど、「たまたま一番良く見える1つ」が生まれる確率は上がる。「回収率100%超」という見出しは、この144通りや48通りの中から一番良い1つを選び出せば、誰にでも作れてしまう数字である。
会場・期間・買い方・信頼度の絞り込みなど、切り口を増やせば増やすほど「一番良い1つ」は簡単に見つかる。それを「実力」と呼ぶか「偶然」と呼ぶかは、同じ切り口で他の候補も並べて見せているかどうかで判断できる。
測り方の詳細数え方と対象の決め方。読まなくても本文の結論は変わりません
- モデル・分割方法は
src/article/track_record.pyの検証と同じ考え方(日付でソートし、末尾の一定割合を検証区間とする。train期間だけで学習し直したモデルでvalid期間だけを評価する)。ただし本記事の実験1・実験2・会場別集計は、検証期間の割合や母集団の定義を差し替える必要があったため、track_record.pyの非公開ヘルパー(_fit・_load_payouts・_load_win_payouts)を呼び出す専用スクリプトarticles/_work/i19_calc.pyを新たに書いた(src/本体は無改造)。 - 集計対象は
data/processed/kyotei.sqliteの 2026-09-23締切(執筆日2026-09-24の前日。これより後のレースは結果が出そろっていない)。特徴量テーブルfeatures.parquetは922,332行、締切で切ると909,648行になる。 - 「検証期間の切り方」は
valid_frac(全レースを日付順に並べ、末尾何%を検証に回すか)を15/18/20/22/25%の5通りに変え、そのたびに学習をやり直した(train期間も連動して変わる)。 - 「対象レースの絞り込み方」は、標準の「6艇完走のみ」(
race_resultに6件そろっているレース)に対し、「5艇以上」(1艇が欠場しても、勝った艇さえ分かれば対象に含める)を比較した。3連単は6艇の全順列で確率を作るため、この実験は単勝のみで行った。 - 会場は
race_idの9〜10桁目(場コード)から会場名に変換した(src/common/constants.pyのPLACE_NAMES)。会場別集計はvalid_frac=20%(検証期間2026-03-08〜2026-09-23)の1回の学習で固定し、母集団だけを24会場に割った。 race_result.rankはTEXT型で'01'〜'06'(ほかにF/S0/S1/S2/K0/K1の失格・欠場コード)。本命1点の的中判定はrank='01'と一致する艇で行っている。- 一度、単勝ROIの集計スクリプトで実装ミスをした。 単勝が外れたレースの払戻額を
0ではなくNone(欠損)として扱っていたため、dropnaで外れたレースが集計から消え、的中したレースだけの平均払戻を「回収率」として出してしまい、単勝ROIが160%という明らかにおかしい値が一時出た。原因はdict.get(key)のデフォルト値を書き忘れたことで、dict.get(key, 0)に直して測り直した。この記事の数字はすべて修正後のものである。 - 本記事の全体の回収率(単勝90.79%・3連単上位6点78.46%、valid_frac=20%・30,645レース)は、以前の記事に載せた78.4%・91〜92%(2026年8月時点の実測)や、以前の記事「会場ランキングの罠」に載せた78.7%・90.5%(2026-09-01時点の実測)とも一致しない。3連単は78.4%→78.7%→78.46%、単勝は91〜92%→90.5%→90.79%と、いずれも過去の実測から数字が動いている。これは3回とも独立に行った実測で、DBが増えるたびに検証期間の始点・終点が自動的にずれるために起きている。モデルの性能が変わったのではなく、測るたびに切り取る期間が少しずつ違う。
では、何を見ればいいのか
「回収率100%超」を掲げる記事や数字を見たときは、次を確認するとよい。
- その数字は1つの検証期間・1つの会場・1つの絞り込み方だけのものか。 期間や会場を変えた別の数字が併記されていなければ、多重比較の結果である可能性を疑う。
- その数字の隣に、悪い数字も並んでいるか。 良い数字だけを見出しに使い、同じ条件で測った他の数字(会場・期間・買い方)を見せない記事は、選び方そのものが結果を作っている。
- 100%という基準に対して、どれだけ余裕があるか。 今回の検証で一番良く見えた下関でさえ、単勝99.0%・3連単88.5%だった。僅差で100%を超えている数字は、母集団を少し変えるだけで割り込む可能性がある。
このツール自身の数字も例外ではない。本記事に載せた90.79%・78.46%という数字も、次に測り直せばまた別の値になる。大事なのは1つの数字を信じることではなく、同じ条件で測り直しても崩れないかを確かめることである。
免責
- 本記事に記載した数値はすべて過去データに対する実測であり、将来の的中や利益を保証するものではありません。
- 本記事および言及したツールは分析の補助を目的としており、舟券の購入を勧誘するものではありません。
- 舟券は20歳未満の方は購入できません。
- 舟券の購入は自己責任で、生活に必要な資金とは別の、余裕資金の範囲で行ってください。のめり込みには十分ご注意ください。