`rank = 1` と書いたら、全枠の1着率が0%になった
このサイトは、公開データと機械学習で競艇の舟券の収支を検証している。回収率が100%に届かないという結論は、もう出ている。今回はその話ではない。集計を書く人が一度は踏む、SQLの地味な罠の話をする。
先に結論を書く。
- 着順の列
race_result.rankは数値ではなく文字列で、1着は1ではなく'01'と入っている。 WHERE rank = 1と書くと、1号艇から6号艇まで、すべての枠の1着率が0.0%になる。 エラーは出ない。- 「3着以内」を
rank <= 3と書くと、98.59% の艇が3着以内という数字になる。正しくは49.99%。 - 正しい書き方は
rank = '01'、rank IN ('01','02','03')。
2024-01-01〜2026-10-07 の 153,827レース(922,962出走行) で、誤ったクエリと正しいクエリを両方走らせて確かめた。
2026年8月31日に、この数字を出しかけた
検証の記録(docs/03_findings.md)に、次の一文が残っている。
2026-08-31にこれで「全枠の1着率0%・3着内率98%」という数字を出しかけた。
1着率0%は、さすがに目で見て気づける。1レースには必ず1着の艇がいるからだ。厄介なのは3着内率98%のほうで、こちらは「やけに高いな」で済ませてしまえる数字である。
今回、同じ誤りを今のデータベースで再現した。
同じ表・同じ期間で、1着率は0%と54.6%に分かれる
枠ごとの1着率を、rank = 1 と rank = '01' の2通りで数えた。分母はどちらも各枠の全出走行(153,827行ずつ)である。
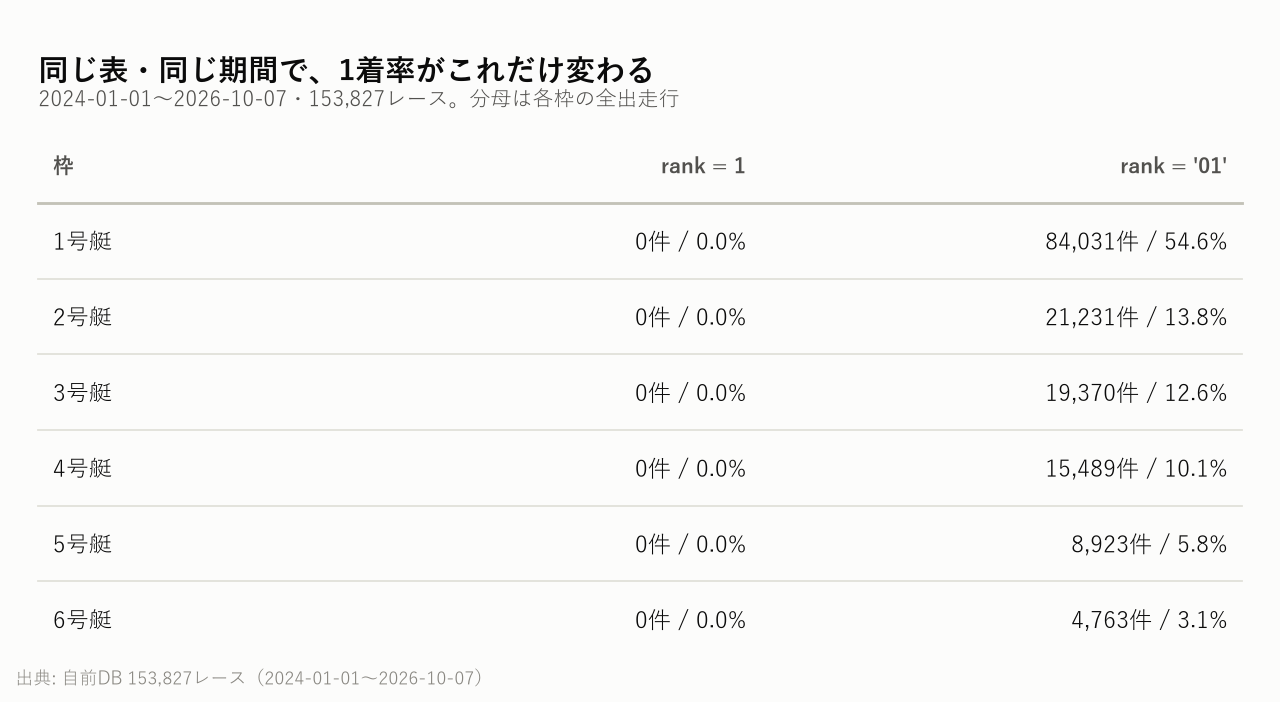
出典: 自前DB 153,827レース(2024-01-01〜2026-10-07)。分母は失格・欠場を含む各枠の全出走行
| 枠 | rank = 1 |
rank = '01' |
|---|---|---|
| 1号艇 | 0件(0.0%) | 84,031件(54.6%) |
| 2号艇 | 0件(0.0%) | 21,231件(13.8%) |
| 3号艇 | 0件(0.0%) | 19,370件(12.6%) |
| 4号艇 | 0件(0.0%) | 15,489件(10.1%) |
| 5号艇 | 0件(0.0%) | 8,923件(5.8%) |
| 6号艇 | 0件(0.0%) | 4,763件(3.1%) |
rank = 1 の列は、6枠すべてが0件だった。クエリは正常に終わり、結果も返ってくる。ただ、中身が全部0になる。
列の中身は文字列の '01'〜'06' と、失格・欠場のコード
rank 列の型はTEXT(文字列)で、値はすべて文字列として入っている。期間内の922,962行を値ごとに数えた。
| 値 | 件数 | 意味 |
|---|---|---|
'01'〜'06' |
909,931 | 着順(1着〜6着) |
'F' |
3,617 | フライング |
'S0' 'S1' 'S2' |
7,488 | 失格 |
'K0' 'K1' |
1,826 | 欠場 |
'L0' 'L1' |
83 | 出遅れ |
'00' |
17 | レース不成立のレースで付いた値(後述) |
| NULL | 0 | — |
コードの意味(F・S・K・L)は、このツールの取り込みコードの注記に従った。同じ記号の0と1と2(K0とK1など)が何を区別しているかは未確認なので、この記事では区別しない。
公式の成績ファイルは着順を「01」のように2桁で書いている。それを数値に直さず、そのまま文字列で保存した。失格や欠場のコードも同じ欄に書かれているので、文字列で持つのは自然な選び方である。罠は、使う側が数値だと思い込むことにある。
rank = 1 が0件になる理由は、SQLiteが1を文字列の '1' に直すから
このデータベースはSQLiteである。SQLiteは、比較の前に型をそろえる規則を持っている。公式ドキュメント(Datatypes In SQLite 4.2節)にこうある。
If one operand has TEXT affinity and the other has no affinity, then TEXT affinity is applied to the other operand.
アフィニティとは、SQLiteで列ごとに付く「この列はこの型として扱う」という目安のことだ。rank 列はTEXTのアフィニティを持つ。そこへ数値の 1 を比べると、1 のほうが文字列の '1' に直される。'01' と '1' は別の文字列なので、一致しない。
実際に rank = '1'(文字列の1)でも数えてみた。結果は rank = 1 と同じく、6枠とも0件だった。数値か文字列かではなく、先頭の0があるかどうかで外れている。
「3着以内」は、書き方しだいで49.99%にも98.59%にもなる
1着率0%は目立つ。危ないのは「3着以内」のような範囲の条件だ。5通りの書き方で、922,962行のうち何%が3着以内と判定されるかを数えた。
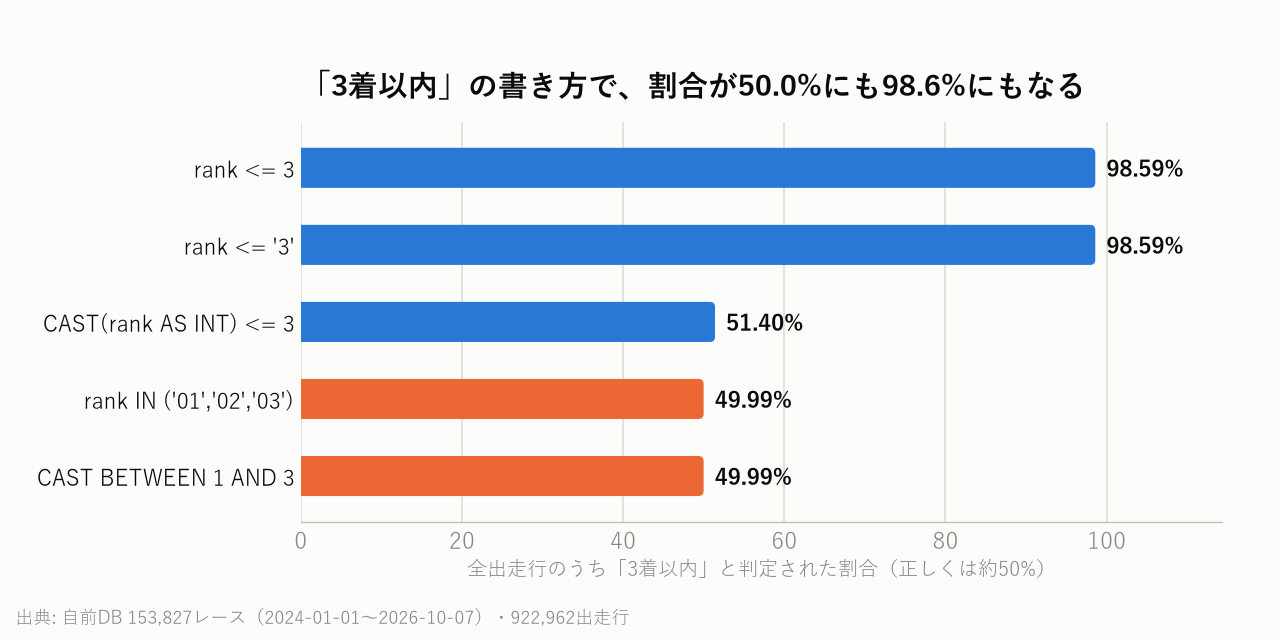
出典: 自前DB 153,827レース(2024-01-01〜2026-10-07)・922,962出走行。オレンジが正しい書き方
| 書き方 | 3着以内と判定 | 割合 | 何を拾ったか |
|---|---|---|---|
rank <= 3 |
909,948 | 98.59% | 4〜6着と '00' まで拾う |
rank <= '3' |
909,948 | 98.59% | 上と同じ |
CAST(rank AS INTEGER) <= 3 |
474,425 | 51.40% | 失格・欠場・出遅れを拾う |
rank IN ('01','02','03') |
461,394 | 49.99% | 正しい |
CAST(rank AS INTEGER) BETWEEN 1 AND 3 |
461,394 | 49.99% | 正しい |
誤り方は2種類ある。
rank <= 3 は、4着も5着も6着も拾う
rank <= 3 は、上と同じ規則で rank <= '3' として扱われる。両者の件数が909,948件で完全に一致したことが、その裏付けになる。
文字列の比較は、先頭の文字から順に比べる(辞書順)。'06' の先頭は '0' で、'3' より小さい。だから '04' も '05' も '06' も、すべて '3' 以下と判定される。拾わないのは、先頭が英字のコード(F・S・K・L)だけだった。
結果として、完走した艇はほぼ全員が「3着以内」になる。98.59%という数字はこうして生まれる。
CAST(rank AS INTEGER) <= 3 は、失格を「0着」として拾う
型が文字列なら数値に直せばいい、と考えて CAST を使うと、別の罠がある。SQLiteは、数値として読めない文字列を 0 に直す。公式ドキュメント(SQL Language Expressions 13節)にこうある。
If there is no prefix that can be interpreted as an integer number, the result of the conversion is 0.
実測でも、'F' 'S0' 'K0' 'L1' '00' などの特殊コードは、すべて CAST で0になった。0は3以下なので、フライング・失格・欠場・出遅れの13,014行と '00' の17行がまとめて「3着以内」に入る。差は1.4ptほどなので、気づきにくい。
CAST を使うなら、BETWEEN 1 AND 3 のように下限も書く。そうすれば0になった特殊コードが外れ、正しい値(49.99%)と一致する。
pandasに持ってきても、同じことが起きる
集計をPython(pandas 3.0.3)で書く場合も確かめた。pd.read_sql で読み込むと、rank 列は文字列の型になる。
| 書き方 | 結果 |
|---|---|
(df["rank"] == 1).mean() |
0.0(全行が不一致) |
(df["rank"] == "01").mean() |
0.1666(922,962行中の1着の割合) |
df.rank == 1 |
False(1つの真偽値) |
df["rank"].astype(int) |
ValueError('F' を整数にできない) |
pd.to_numeric(df["rank"], errors="coerce") |
13,014行がNaN(欠損値)になる |
3つ目は別の罠だ。pandasでは df.rank は列ではなく、順位を付けるメソッド(関数)を指す。列名が rank だと、ドットで書いた瞬間に関数と1を比べることになり、ただの False が返る。列は必ず df["rank"] と角かっこで書く。
astype(int) だけは、エラーで止まってくれる。黙って0を返すより、止まってくれるほうが親切である。
失格も欠場も、NULLではなくコードで入っている
「欠場の艇は着順がNULL(値なし)だろう」と考えて rank IS NULL で除くと、何も除けない。期間内に rank がNULLの行は0件だった。どのレースも6行そろっていて、欠場の艇も 'K0' などのコードを持った行として残っている。
NULLになっているのは、着順以外の列である。コードごとに、他の列が埋まっているかを数えた。
rank |
行数 | スタートタイミング | 進入コース | 展示タイム | レースタイム |
|---|---|---|---|---|---|
'01' |
153,807 | あり | あり | あり | あり |
'F' |
3,617 | あり | あり | あり | 全行NULL |
'S0' 'S1' 'S2' |
7,488 | あり | あり | あり | 全行NULL |
'K0' 'K1' |
1,826 | 全行NULL | 全行NULL | 全行NULL | 全行NULL |
'L0' 'L1' |
83 | 全行NULL | 全行NULL | 全行NULL | 全行NULL |
'00' |
17 | あり | あり | あり | 全行NULL |
欠場と出遅れの行は、着順以外がすべて空になる。フライングと失格の行は、スタートまでの記録は残り、レースタイムだけが空になる。進入コースやスタートの分析で「NULLを除けば失格が消える」と考えると、フライングと失格の艇は残る。
1着の艇がいないレースが22件、1着が2艇のレースが2件あった
「1レースには必ず1着がいる」は、データの上では成り立たない。期間内に '01' が1艇もいないレースが22件あった。
- 6艇すべてがフライング: 4件
- 5艇がフライングで、残る1艇が
'00': 16件 - 6艇すべてが失格(S0〜S2): 1件
- 5艇が失格で、残る1艇が
'00': 1件
'00' は、この「レース不成立」になったレースで、フライング・失格にならなかった1艇だけに付いていた。17件すべてがそうだった。公式の成績ファイルでも、該当レースには「レース不成立」と書かれている(2026-03-11 福岡8Rで確認)。
逆に、'01' が2艇いるレースも2件あった。同着である。
このため、1着の行の総数は153,807行で、レース数の153,827とは一致しない(153,827 − 22 + 2 = 153,807)。「1着の行数=レース数」を前提にした検算は、20件ずれる。
フライングは、スタートタイミングのマイナス値ではない
「フライングはスタートが早すぎた艇なので、スタートタイミングがマイナスで入っているはず」と考えるのも外れる。start_timing 列もTEXTで、マイナスで始まる値は0件だった。
フライングの艇は、'F0.01' のように先頭に F が付いた文字列で入っている。3,617行すべてがこの形だった。フライングを見分けるには、rank = 'F' を使う。
ここにも CAST の罠がある。CAST(start_timing AS REAL) で数値に直すと、'F0.01' は先頭が数字ではないので 0.0 になる。3,617行のフライングが、すべて「スタートタイミング0.00秒」として数えられる。
| 平均スタートタイミング | 値 |
|---|---|
| フライングを0.00秒として含めた場合 | 0.1621秒 |
| フライングを除いた場合 | 0.1627秒 |
全体の平均への影響は小さい。ただし向きが悪い。フライングで失格になった艇を、もっとも完璧なスタートとして数えることになる。艇ごと・選手ごとのスタート分析では、この誤りが結果を大きく動かす可能性がある(選手単位での影響の大きさは未検証)。
失格・欠場を母数に入れるかで、1号艇の1着率は0.7pt動く
正しく '01' で数えても、まだ選択が残る。分母に失格・欠場のあったレースを入れるかどうかだ。
| 母集団 | レース数 | 1号艇の1着率 |
|---|---|---|
| 結果がある全レース(失格・欠場を含む) | 153,827 | 54.63% |
6艇とも '01'〜'06' で完走したレース |
143,272 | 55.33% |
差は約0.7pt。どちらが正しいかではなく、どちらで数えたかを書くことが必要になる。同じ「1号艇の1着率」でも、記事によって数字が違って見える原因になるからだ。
もう1つ、番組表(race テーブル)にはあるのに、結果の行が1件も無いレースが1,957件(165日分)あった。この記事の153,827レースには入っていない。中止になったレースが中心だと考えているが、1件ずつの理由は未検証である。
書き方の約束と、気づくための検算
検証の記録で決めた書き方(1)に、今回の実測で分かったこと(2〜5)を足すと、次のようになる。
- 着順は文字列で比べる。
rank = '01'、rank IN ('01','02','03')。 - 数値に直すなら、下限も書く。
CAST(rank AS INTEGER) BETWEEN 1 AND 3。 - フライングは
rank = 'F'で見分ける。start_timingの符号では見分けられない。 - pandasでは列を
df["rank"]と書く。df.rankは使わない。 - 母集団(失格・欠場を含むか)を、数字と一緒に必ず書く。
書き方を決めても、間違いはまた起きる。だから、結果を見たときの検算を1つ持っておく。6枠の1着率を足すと、ほぼ100%になるはずである。今回の正しいクエリでは、6枠の1着数の合計153,807件をレース数153,827で割って99.99%だった。誤ったクエリでは0%になる。
3着内率も同じで、6艇立てのレースなら全体のほぼ50%(6艇中3艇)になるはずだ。98.59%が出た時点で、どこかがおかしいと分かる。
値そのものを疑う前に、「合計が何%になるべきか」を先に決めておく。 地味だが、エラーを出さない罠に気づく手段としては、こうした検算が効果的だと考えている。
この記事で確かめたこと・確かめなかったこと
- 確かめた: 2024-01-01〜2026-10-07 の153,827レースで、誤ったクエリ(
rank = 1、rank <= 3、CASTの使い方)と正しいクエリを両方実行し、結果の差を実数で出した。 - 確かめた: SQLiteの比較と
CASTの規則を公式ドキュメントで確認した(SQLite 3.49.1 で実行)。 - 確かめた:
'00'が付いた17件がすべてレース不成立のレースだったこと。 - 確かめなかった: K0とK1、S0〜S2などの数字の違いが何を区別しているか。
- 確かめなかった: 番組表にあって結果の無い1,957件の、1件ずつの理由。
- 確かめなかった: フライングを0.00秒と数えた場合の、選手単位での影響の大きさ。
なお、この記事は集計の書き方の話で、舟券の買い方の話ではない。このツールの検証では、試した買い方の回収率はいずれも100%に届いていない(2026年8月30日時点の実測で、3連単上位6点が78.4%、単勝本命1点が91〜92%)。正しく数えても、その結論は変わらない。
免責
- 本記事に記載した数値はすべて過去データに対する実測であり、将来の的中や利益を保証するものではありません。
- 本記事および言及したツールは分析の補助を目的としており、舟券の購入を勧誘するものではありません。
- 舟券は20歳未満の方は購入できません。
- 舟券の購入は自己責任で、生活に必要な資金とは別の、余裕資金の範囲で行ってください。のめり込みには十分ご注意ください。